2026-11-03
 阅读:31
 来源:曲速超维集成电路
从异构特征中提取多样信息 在两组表格预测基准上取得领先的平均排名
在房价预测、客户分析和风险识别等任务中,表格是连接数据与决策的常见载体。一行记录描述一个对象,不同列分别记录它的属性。看似规整的行列之间,却包含了类型、尺度和语义各不相同的信息。让模型充分理解这些差异,是提升表格预测能力的重要一步。
围绕这一问题,我们提出表格学习框架 MAYA(Multi-branch of Attention Yields Accurate Results for Tabular Data)。它通过多分支注意力提取不同角度的特征关系,再利用样本间注意力结合训练样本的标签信息,完成分类与回归预测。在论文采用的两组基准中,MAYA 均取得了所比较的 Transformer 方法中最优的平均排名。
01 表格数据需要怎样的注意力
以一张客户信息表为例,年龄和收入是数值,职业和地区是类别,不同字段的取值规律与业务含义差别很大。同一字段也会随其他条件改变作用:收入对预测结果的影响,可能与年龄、职业共同相关。这个例子说明,表格建模既要保留字段各自的特点,也要识别字段之间的组合关系。
Transformer 的注意力机制能够学习这些关系。将各列映射为特征向量后,模型可以根据数据判断哪些字段应该相互关联。但表格数据的异构性意味着,不同的预测线索可能需要不同的交互方式:有些依赖少数关键字段,有些需要综合多列信息。
一种直接的思路是增加注意力头,让模型从更多子空间观察特征。不过,头数、每个头的维度和模型的总维度之间存在约束。在总维度固定时,增加头数会压缩每个头的表示空间;如果保持每个头的维度并同步扩大总维度,后续前馈网络的参数开销又会明显增加。
能否保留多个充分表达的注意力视角,同时控制后续网络的维度和参数增长? MAYA 的多分支注意力正是从这个问题出发。
02 MAYA 同时学习一行之内与多行之间的关系
MAYA 采用编码器与解码器结构,将表格预测分成两个相互衔接的过程。
首先,Tokenizer 将数值特征和类别特征映射到统一的向量空间,并加入用于汇总样本信息的 [CLS] 标记。编码器通过多层多分支注意力,学习一条记录内部各字段之间的关系,最终得到样本级表示。
随后,解码器利用样本间注意力,将当前样本与参考样本联系起来,并引入参考样本对应的标签信息。经过这一过程,预测层输出类别或回归数值。
编码器回答哪些字段应当一起看,解码器进一步利用其他已知样本所提供的信息。 两种注意力分别作用于特征之间和样本之间,共同服务于最终预测。
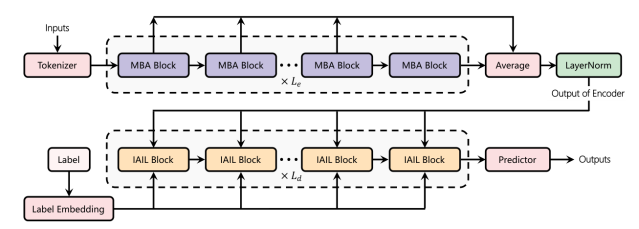
图1 MAYA 整体架构。编码器由 MBA 模块构成,解码器由 IAIL 模块构成。图源为论文图2。
03 多分支注意力如何兼顾多样性与参数效率
多个分支并行观察同一条记录
多分支注意力模块 MBA(Multi-Branch of Attention)在同一个编码器模块中设置多个并行分支。每个分支内部都是多头注意力,接收相同输入,但拥有各自的注意力参数,因此可以学习不同的字段交互模式。
这些分支共享前馈网络 FFN,并分别进行归一化处理;分支输出通过平均或加权平均进行融合,再结合残差连接与归一化,得到模块输出。多个 MBA 模块继续堆叠,编码器还对不同层的输出进行平均与归一化,汇总多层信息。
这里的关键在于,分支融合后仍保持原有的隐藏维度。增加分支可以扩展注意力的观察角度,而不必将所有分支表示拼接成更宽的向量,再把维度增长传递给后续 FFN。
需要区分的是,多分支本身仍会增加注意力参数和计算。MBA 的参数效率,主要体现在控制表示维度,以及共享 FFN 所带来的参数复用。
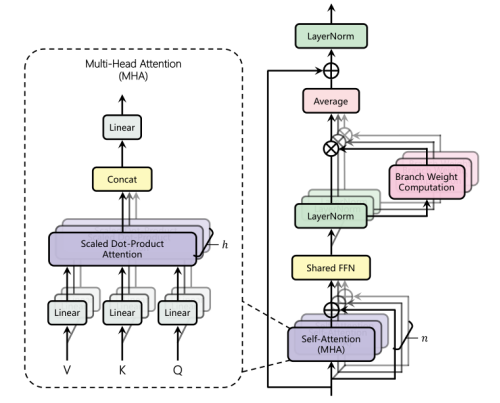
图2 多分支注意力 MBA。多个独立注意力分支共享 FFN,并在分支层面完成融合。图源为论文图1。
让预测偏差较大的分支获得更多关注
多个分支建立起来后,如何让它们共同参与学习?MAYA 在训练过程中引入了动态分支权重。
具体来说,我们为各分支接入一个共享预测层,用真实标签计算分支的预测损失:分类任务采用交叉熵,回归任务采用均方误差。各分支损失经过 Softmax,再通过指数移动平均 EMA 平滑,得到融合权重。
这一机制有一个容易被忽略的特点:损失较大的分支会被赋予较大的权重。 它着眼于训练中的协同与平衡,让偏差较大的分支得到更多关注,而非简单地把融合权重集中到当前预测最好的分支上。
动态权重与独立注意力分支共同发挥作用:前者协调分支的学习,后者保留不同的特征交互视角。
不同分支学到了什么
论文在 Shrutime 数据集上展示了一个 MBA 模块的注意力图。该模型每层包含三个分支,每个分支包含四个注意力头,图中选取第五层进行观察。
可视化中,部分分支更集中于少数特征,呈现较稀疏的关注模式;部分分支覆盖更广,体现更密集的特征交互;还有分支表现出两者结合的模式。对照 CatBoost 给出的特征重要性,若干重要字段也在不同分支中对 [CLS] 标记产生了较明显的贡献。
这些观察为分支之间存在互补性提供了直观证据:同一条记录可以被多个具有不同偏好的注意力分支共同表示。
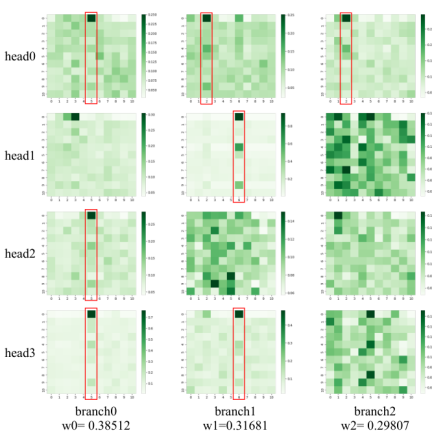
图3 不同分支的注意力可视化。各列对应不同分支,各行对应分支内的注意力头。图源为论文图1。
04 利用已知样本的标签辅助预测
完成单条记录的特征提取后,MAYA 进一步引入 IAIL(Inter-instance Attention Incorporated with Labels),即融合标签信息的样本间注意力模块。
可以把它理解为在学到的表示空间中参考已有案例。例如,预测一套房屋的价格时,模型除了分析房屋自身的属性,还可以利用训练集中相关房屋的特征与已知价格。
在 IAIL 中,每个样本由编码器输出的紧凑向量表示。当前待处理表示形成 Query,参考样本的编码表示形成 Key,参考样本的标签嵌入形成 Value。模型根据表示之间的关系聚合标签信息,并通过后续网络完成预测。论文采用基于 L2 距离的相似性计算,IAIL 本身无需使用多头注意力。
训练与推理所使用的参考范围有所不同:训练时,Key 和 Value 来自当前训练批次的样本及其标签;推理时,则以训练集样本的编码表示和标签嵌入作为参考。预测测试样本时,所使用的是训练集的已知标签。
这一设计让标签除了参与损失计算,也能作为预测过程中的参考信息。每个参考样本被压缩为一个样本级向量,避免在解码器中保留其全部字段标记;同时,参考训练集也意味着部署时需要考虑参考表示的存储与访问开销。
05 两组基准检验整体预测能力
论文在两组基准上开展评估:第一组包含14个数据集,第二组包含22个数据集条目,覆盖二分类、多分类和回归任务。
对比方法包括 AutoInt、TabTransformer、SAINT、FT-Transformer、ExcelFormer 和 AMFormer。第二组受计算资源和时间限制,未纳入 SAINT。分类任务以准确率衡量,回归任务采用均方根误差 RMSE;同时使用跨数据集平均排名评价整体表现,排名数值越小越好。
论文按每个数据集或数据划分使用15个随机种子的方式评估,并报告均值与标准差。MAYA 使用 Optuna 进行100次超参数搜索;超参数选择基于训练集和验证集。
| 方法 | 第一组平均排名 | 第二组平均排名 |
| AutoInt | 4.5714 | 4.6818 |
| TabTransformer | 6.4286 | 5.9545 |
| SAINT | 4.0000 | 未纳入比较 |
| FT-Transformer | 3.5714 | 2.7727 |
| ExcelFormer | 3.6429 | 2.9545 |
| AMFormer | 3.5000 | 2.6818 |
| MAYA | 2.2857 | 1.9545 |
表1 两组基准的平均排名,数值越小越好。数据来自论文表1与表2;两组候选方法不同,排名在各组内比较。
MAYA 在两组中均取得最优平均排名,说明其优势体现于跨任务的整体表现。在具体任务上,第一组 California Housing 的 RMSE 从 FT-Transformer 的0.4564降至0.4373,相对降低约4.2%;第二组 electricity 的准确率从 FT-Transformer 的83.39%提升至84.34%,提高0.95个百分点。
06 哪些设计带来了收益
多分支优于简单扩展注意力头的整体表现
为检验 MBA 的作用,论文将其替换为单分支多头注意力,并比较两种受控配置:一种保持总隐藏维度接近一致,另一种保持每个头的维度一致。两者均使单分支的总头数与原 MBA 的总头数一致。此外,论文还测试了可自由调参的单分支版本,以及移除动态分支权重的版本。
在六个消融数据集上,完整 MAYA 的平均排名为1.6667,优于上述各配置。结果支持多分支设计在表示能力和参数开销之间的权衡,也显示动态权重对整体表现具有帮助。
在保持每个头维度一致的单分支配置中,论文估算的编码器主要权重参数量达到 MAYA 的4.2至12.8倍。以 California Housing 为例,该配置的编码器参数量约为 MAYA 的12倍,RMSE 为0.4412,而 MAYA 为0.4373。
样本关系与标签信息提供补充
解码器消融进一步比较了移除解码器、保留样本间注意力但移除标签输入,以及完整 MAYA 三种方案。
| 配置 | 六个数据集上的平均排名 |
| 移除解码器 | 3.0000 |
| 保留解码器但不引入标签 | 1.8333 |
| 完整 MAYA | 1.1667 |
表2 IAIL 消融结果,数值越小越好。数据来自论文表4。
这一结果表明,仅加入样本间关系建模,就能改善整体表现;进一步引入标签信息,还能取得额外收益。例如,QSAR Bio 的准确率从不使用标签时的83.92%提升至85.15%。
此外,论文在 Tokenizer 后增加 ReLU 激活函数,并通过消融发现,该设计在所测试的六个数据集上均带来改善。特征进入注意力模块之前的处理,同样会影响最终预测效果。
07 面向异构表格数据的架构探索
MAYA 展示了一条结合多视角特征提取与样本参考信息的表格建模路径。编码器通过独立注意力分支学习不同的字段交互方式,并以共享 FFN 和分支融合控制参数增长;解码器则把训练样本及其已知标签作为预测参考,让模型进一步利用样本之间的关系。
对房价预测、客户行为分析等结构化数据任务,这种架构提供了可供评估的新选择。实际应用中,仍需结合目标数据集检验预测收益,并评估训练集参考访问所带来的时延、存储与维护成本。
表格的行列形式可以保持不变,模型理解数据的方式却可以更细致。如何让不同特征得到充分表达,又让已有样本的信息被有效利用,是 MAYA 这项工作的出发点,也为后续表格学习架构的探索提供了参考。
论文与代码
论文题目:Multi-branch of Attention Yields Accurate Results for Tabular Data
作者:Xuechen Li、Yupeng Li、Jian Liu、Xiaolin Jin、Xin Hu
作者单位:Shanghai Warpdrive Technology Co.,Ltd.
代码与数据地址:https://github.com/AlfredTino/maya_codes
参考文献
[1] Li X, Li Y, Liu J, Jin X, Hu X. Multi-branch of Attention Yields Accurate Results for Tabular Data. MAYA 论文。
[2] Gorishniy Y, Rubachev I, Khrulkov V, Babenko A. Revisiting Deep Learning Models for Tabular Data. NeurIPS, 2021.
[3] Somepalli G, Goldblum M, Schwarzschild A, Bruss C B, Goldstein T. SAINT: Improved Neural Networks for Tabular Data via Row Attention and Contrastive Pre-Training. arXiv:2106.01342, 2021.
[4] Chen J, Yan J, Chen Q, Chen D Z, Wu J, Sun J. Can a Deep Learning Model Be a Sure Bet for Tabular Prediction? KDD, 2024.
[5] Cheng Y, Hu R, Ying H, Shi X, Wu J, Lin W. Arithmetic Feature Interaction Is Necessary for Deep Tabular Learning. AAAI, 2024.
[6] Gorishniy Y, Rubachev I, Kartashev N, et al. TabR: Tabular Deep Learning Meets Nearest Neighbors. ICLR, 2024.